

WIN/MAC均为独家一键安装
不换话筒,换的是性格
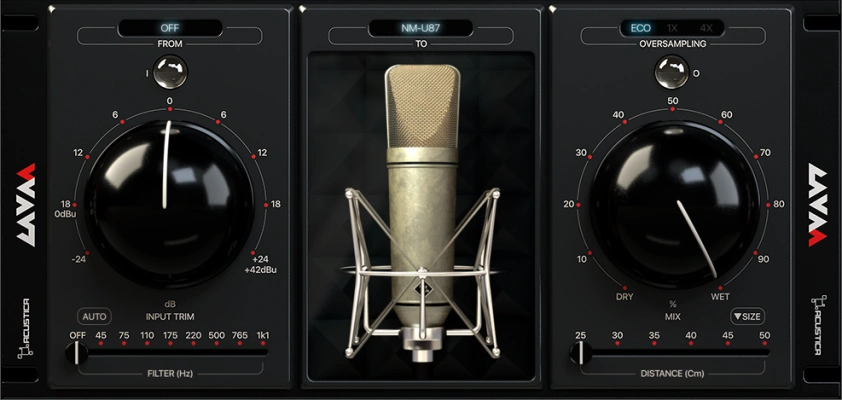
录人声的人都有这种经验:看上一支话筒,手头却只有那一支。Lava 的思路是在数字端补这一课——它不去贴一条大路货的均衡曲线,而是去建模话筒本身的行为,让现有话筒录出来的东西往目标型号上靠。官方的说法是几处调整就能让手里这支听起来像梦想里的那一支。
一百四十一种仿真装在一个插件里
页面给出的数字是一百四十一种话筒仿真,跨度从最便宜、最有趣的老话筒,到市面上最稀有的精品型号。使用逻辑是两段式的:先告诉插件你实际用的是哪一类话筒,再选想变成的那一只,中间的差异由模型补出来。声源与目标两组设定让同一份素材能反复试不同组合。
响应、谐波、近讲三件事一起仿
话筒之间的差别不只在频响曲线上。Lava 宣称同时还原了响应、谐波成分与近讲效应三件事,其中近讲效应尤其关键——歌手贴近话筒时低频抬升多少,是区分不同型号的重要特征,也是普通均衡最难模仿的部分。三件事一起建模,音色迁移才不停在亮度变了这一层。
录制与后期都能站岗
官方把它的使用场景写成录音、混音,以及广播与播客人声。对已经录完的素材,它可以当补救工具,把过亮或过闷的人声往另一支话筒的性格上带;对录制阶段,则能挂在监听链路上先听效果再定摆位。厂家另给了标准与零延迟两种形态,兼顾监听时的时延。
本包实测形态
本包为行内标注版本,实测 1.89GB,盘内含单一仿真模块(完整名见上),双平台,运行于厂家自家的 Acqua 播放器。官方页面把它归入混音、声音设计与话筒等目录,适合以人声为主、又不想在话筒库存上无限投入的制作人。
务必先安装Acustica Audio Framework 2023
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END



暂无评论内容